Риски цифрового бизнеса в России к концу 2026 года: киберугрозы, инфраструктура ЦОДов и практические меры защиты
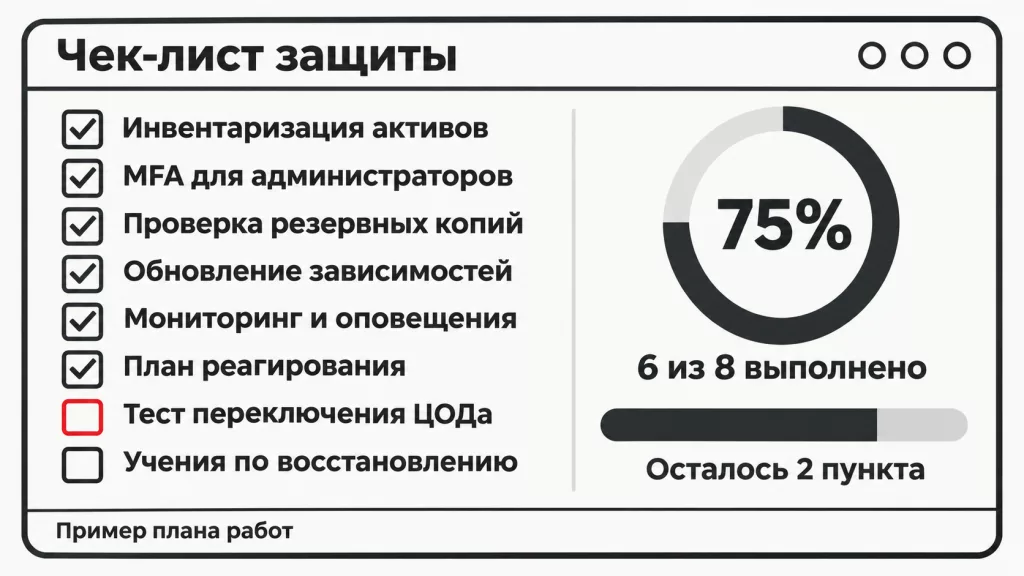
Мой взгляд на угрозы для цифрового бизнеса к концу 2026 года: прикладные кибератаки, риски инфраструктуры ЦОДов, цепочки поставок, данные и организационные факторы. Разбираю приоритеты и практические меры минимизации с инженерной точки зрения.
Вместо вступления: почему я пишу об этом именно сейчас
Мне довелось строить и сопровождать веб-системы с середины нулевых, когда «отказоустойчивость» означала второй физический сервер в соседней стойке, а «безопасность» — вовремя поставленный патч и закрытый наружу SSH. За пятнадцать с лишним лет я прошёл через монолиты, микросервисы, контейнеры, облака и обратно к гибридным схемам. И сейчас, к концу 2026 года, я вижу, как цифровой бизнес в России столкнулся с набором рисков, которые отличаются от всего, что было раньше, не столько природой угрозы, сколько её плотностью и системностью.
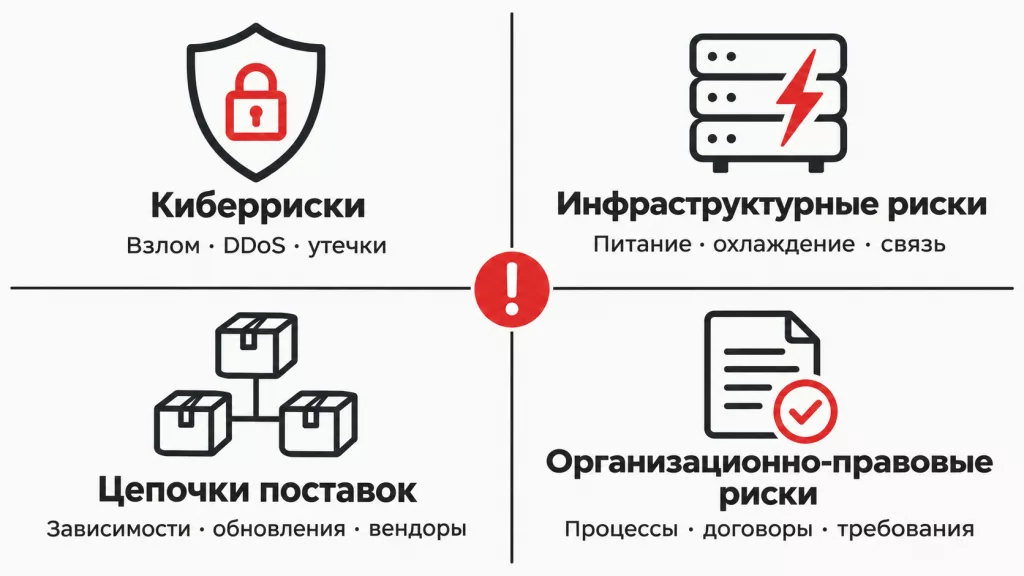
Речь пойдёт не о панике, а о инженерии. Я постараюсь разложить риски на категории, показать, где они бьют больнее всего, и дать конкретные практики минимизации, которые я применял сам или видел работающими у коллег. Часть угроз лежит в плоскости кибербезопасности, часть — в плоскости инфраструктуры ЦОДов и цепочек поставок, а часть — в плоскости организационной и юридической. Игнорировать любую из этих групп сегодня означает сознательно оставлять бизнес уязвимым.
Ландшафт угроз в конце 2026 года: что изменилось
Если смотреть на ситуацию глазами инженера, а не аналитика, ключевое изменение последних двух-трёх лет — это переход от точечных инцидентов к непрерывному фоновому давлению. Атакующая сторона автоматизировала разведку, подготовку и первичное проникновение. То, что раньше требовало команды из нескольких человек и недель подготовки, теперь частично выполняется конвейером с минимальным участием человека. Среднее время от появления уязвимости до её массовой эксплуатации сократилось до часов, а иногда и до минут.
Второе изменение — экономика атак. Цифровизация бизнеса увеличила поверхность атаки, но одновременно создала рынок, на котором доступ к инфраструктуре и данным имеет цену. Это значит, что мотивация атакующих стала устойчивой и коммерчески осмысленной, а не зависящей от разовых кампаний. Для бизнеса это означает, что «нас не тронут, мы маленькие» перестаёт работать: массовые автоматизированные сканирования не разбирают, кто вы и насколько вам интересны лично.
Третье изменение — гетерогенность инфраструктуры. Средний российский цифровой бизнес в 2026 году редко живёт в одном облаке или в одном ЦОДе. Обычно это гибрид: часть нагрузки в собственном железе, часть в облаке, часть в арендованных стойках, часть — во внешних сервисах. Каждый стык — это риск, и чем больше стыков, тем сложнее их контролировать.
Категория риска | Характер в 2026 году | Кого затрагивает в первую очередь |
|---|---|---|
Кибератаки на приложения | Автоматизированные, непрерывные, часто нацелены на API | E-commerce, финтех, SaaS |
Атаки на инфраструктуру ЦОДов | Комбинированные, с физической и логической составляющей | Все, кто арендует стойки или полные залы |
Цепочки поставок ПО | Компрометация зависимостей и обновлений | Разработчики и все, кто использует сторонние библиотеки |
Утечки данных | Рост объёма и последствий, включая регуляторные | Бизнесы с персональными данными |
Простой из-за зависимости от внешних сервисов | Каскадные отказы | Все, кто полагается на единственного провайдера |
Организационные и правовые | Ужесточение требований и рост цены ошибки | Средний и крупный бизнес |
Кибератаки на бизнес-приложения: от DDoS до логических брешей
Начну с того, что вижу чаще всего. DDoS-атаки никуда не делись, но изменили профиль: сейчас это не столько «залить канал», сколько «избирательно вывести из строя конкретный слой». Атаки на уровень приложений, на API, на авторизацию — вот что реально ломает бизнес. Классическая защита на уровне сети уже не спасает, если злоумышленник имитирует легитимный трафик и бьёт по дорогим операциям: поиску, оформлению заказа, генерации отчёта.
Логические уязвимости — отдельная боль. За пятнадцать лет я неоднократно видел, как бизнес-логика оказывается слабее, чем инфраструктура. Пример из практики: правильно настроенный WAF, шифрование, мониторинг — и при этом возможность через манипуляцию параметрами получить доступ к чужому заказу. Такие бреши не ловятся сканерами, их находят либо вручную, либо через грамотно выстроенный процесс ревью и тестирования.
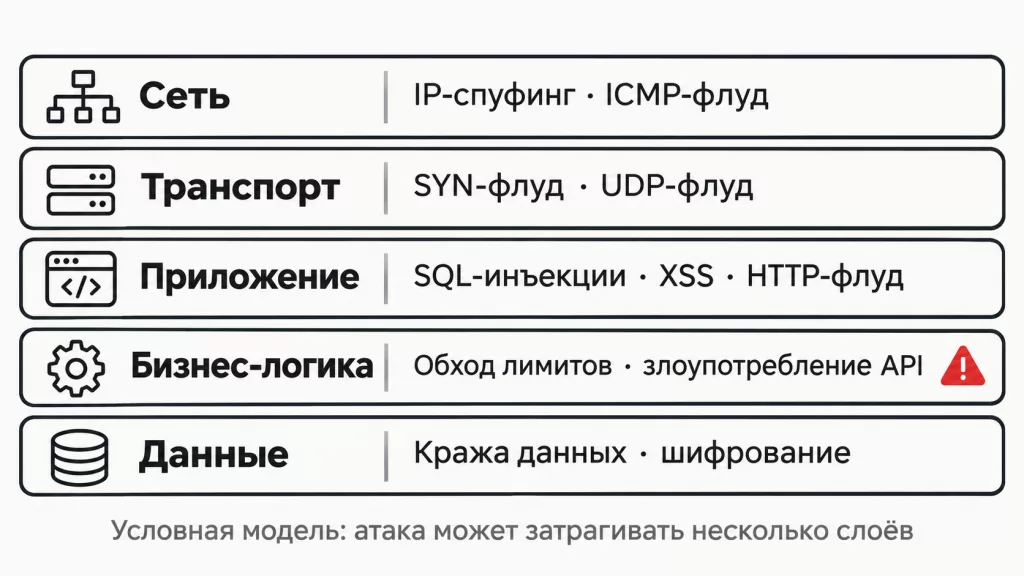
Атаки на API и авторизацию: обход контроля доступа, повторное использование токенов, IDOR
Атаки на бизнес-логику: манипуляция ценами, скидками, лимитами, статусами заказов
Эксплуатация зависимостей: уязвимости в сторонних библиотеках и фреймворках
Социнженерия против сотрудников: фишинг, поддельные панели входа, выманивание кодов
Автоматизированный перебор и credential stuffing на формы входа
Что делать с прикладными киберисками
Мой подход за годы устоялся и сводится к нескольким принципам. Первый — безопасность как часть пайплайна, а не отдельная фаза перед релизом. SAST и сканеры зависимостей должны стоять в CI, а не запускаться раз в квартал по расписанию. Второй — модель угроз для каждой критичной фичи, а не для системы в целом. Когда команда садится и честно отвечает на вопрос «как это можно сломать», половина проблем отваливается ещё на этапе дизайна.
Третий — минимизация доверия между компонентами. Внутренние сервисы не должны доверять друг другу по факту нахождения в одной сети. mTLS, подписанные токены, явные политики — это не паранойя, это норма для 2026 года. Четвёртый — управление секретами. Я до сих пор встречаю в продакшене конфиги с паролями в открытом виде, и это одна из самых недооценённых дыр.
Пятый — регулярные учения. Не пентест раз в год, а постоянные короткие проверки: кто-то из команды пытается пройти по сценарию атакующего на стейдже, и по результатам заводится задача. Это дёшево, быстро и, по моему опыту, даёт больше, чем формальный аудит.
# пример шагов пайплайна с проверками безопасности
stages:
  - lint
  - sast
  - dependency_scan
  - secret_scan
  - build
  - test
  - deploy_staging
  - dynamic_scan
  - deploy_prod

rules:
  block_on_critical: true
  block_on_secrets: true
  allow_manual_override: false
Инфраструктура ЦОДов: риски, о которых не любят говорить в маркетинге
Теперь про инфраструктуру. ЦОД — это физическое сооружение, и у него есть физические уязвимости: электропитание, охлаждение, каналы связи, физический доступ, персонал. В 2026 году к этому добавился слой, который раньше был скорее теоретическим. Речь о комбинированных воздействиях, когда логический инцидент совпадает по времени с физическим событием, и системы защиты, рассчитанные на что-то одно, начинают работать вразнобой.
Я не буду здесь описывать сценарии, которые всем понятны без пояснений. Скажу инженерно: последние годы показали, что площадка, у которой нет географического разнесения и автономных резервов, уязвима к событиям, которые ранее считались маловероятными. Резервирование питания, независимые каналы, раздельные площадки — это не про паранойю, это про то, что стоимость простоя в 2026 году для цифрового бизнеса измеряется не часами, а выручкой и репутацией.
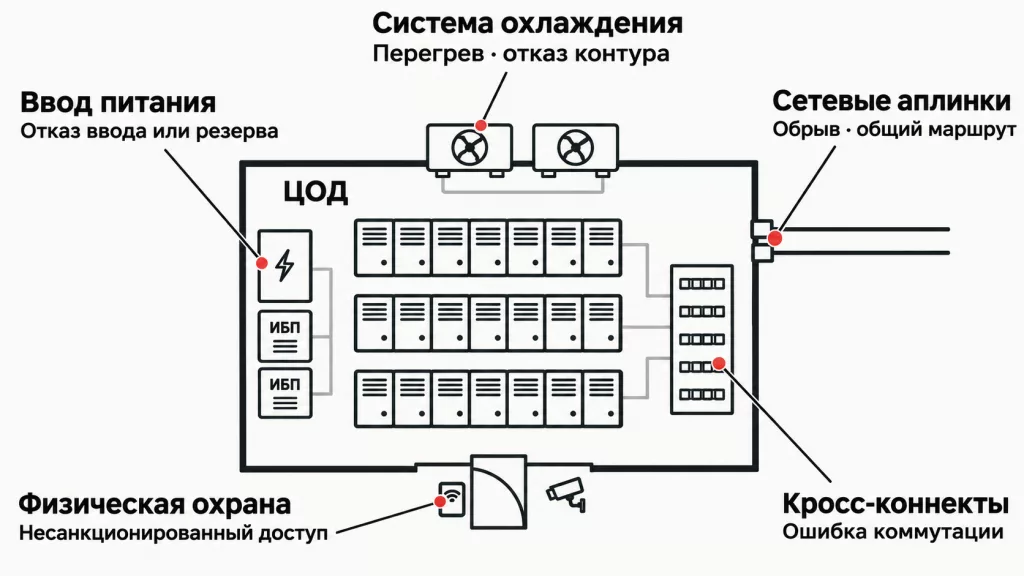
Компонент ЦОДа | Типовой риск | Базовая мера снижения |
|---|---|---|
Электропитание | Отказ ввода, сбой ИБП, недостаток мощности | Два независимых ввода, N+1 по ИБП, регулярные тесты под нагрузкой |
Охлаждение | Отказ чиллеров, перегрев зала | Резервирование, датчики по зонам, регламент аварийного снижения нагрузки |
Каналы связи | Обрыв, деградация, единая точка отказа | Минимум два провайдера с разными трассами, BGP-резервирование |
Физический доступ | Несанкционированное проникновение | Многофакторный контроль, видеонаблюдение, журналирование входов |
Персонал | Ошибка, инсайд | Разделение ролей, ротация доступов, аудит действий |
Зависимость от единственного ЦОДа и от единственного провайдера
Этот риск я ставлю в топ по частоте. Бизнес вырос, арендовал стойки в удобном ЦОДе, всё работает — и вдруг один инцидент на площадке останавливает всё. Причина почти всегда одна: архитектура не предполагала географического разнесения, потому что «так дешевле и проще». Дешевле — до первого крупного простоя.
Минимизация здесь не сводится к «арендовать второй ЦОД». Нужна осознанная стратегия: какие сервисы критичны настолько, что должны пережить потерю площадки, а какие могут быть временно недоступны. Не всё нужно дублировать. Но то, что дублируется, должно дублироваться по-настоящему: с репликацией данных, с проверенными процедурами переключения и с регулярными учениями по переключению. Переключение, которое никто не проверял, — это не резервирование, а иллюзия.
Отдельно про провайдеров. В 2026 году стало нормой проверять не только SLA, но и то, как провайдер сам резервирован, как он раскрывает инциденты и есть ли у него независимые площадки. Я всегда прошу у провайдера схему его собственной отказоустойчивости, и по реакции на этот запрос многое становится понятно.
Цепочки поставок ПО и железа
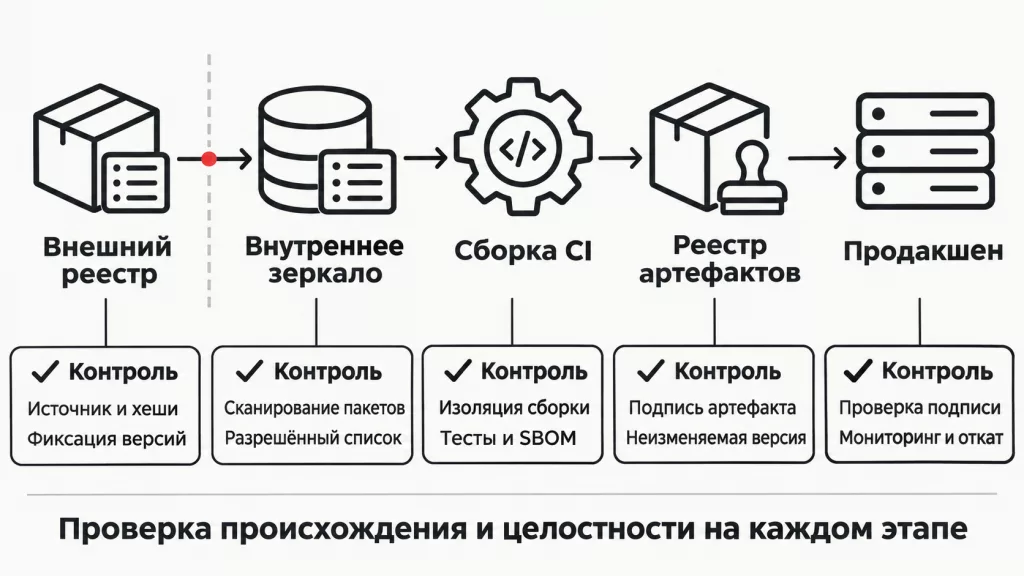
Цепочка поставок — это, пожалуй, самый недооценённый риск для среднего бизнеса. Мы зависим от библиотек, контейнеров, образов, обновлений и железа. Каждое звено — потенциальная точка компрометации. Случаи, когда вредоносный код попадал в популярную зависимость или в обновление, уже стали частью отраслевой истории, и полагаться на «нам повезёт» не стоит.
Что реально работает: фиксация версий и хешей, собственный внутренний реестр артефактов, обязательная проверка подписей, запрет на прямое скачивание зависимостей из интернета во время сборки, регулярная инвентаризация того, что используется. Я знаю команды, которые внедрили это за пару месяцев и сильно снизили поверхность риска при минимальных затратах.
Фиксируйте версии и контрольные суммы всех зависимостей
Держите внутренний реестр и зеркала, не собирайте напрямую из внешних источников
Проверяйте подписи и происхождение артефактов там, где это поддерживается
Ведите реестр используемых компонентов и регулярно его пересматривайте
Отслеживайте уведомления об уязвимостях и имейте регламент реакции на них
Данные: доступ, хранение, утечки
Утечка данных в 2026 году — это не только репутационный удар. Это регуляторные последствия, это потеря доверия партнёров, это судебные издержки. И это, к сожалению, то, что случится с вероятностью выше нуля почти у любого цифрового бизнеса. Поэтому стратегия должна строиться не на «как не допустить утечку вообще», а на «как минимизировать ущерб, когда она случится».
Практически это означает: минимизация объёма хранимых данных, разграничение доступа по принципу необходимости, шифрование в покое и при передаче, ротация ключей, логирование доступа к чувствительным данным. И главное — готовность быстро установить, что именно утекло, и быстро отреагировать. Компании, у которых есть отлаженный процесс, переживают инцидент иначе, чем те, кто начинает разбираться с нуля.
Мера | Что даёт | Сложность внедрения |
|---|---|---|
Минимизация хранимых данных | Снижает объём потенциальной утечки | Низкая |
Разграничение доступа по ролям | Ограничивает масштаб инцидента | Средняя |
Шифрование в покое | Защищает при утечке носителей и бэкапов | Средняя |
Ротация ключей и секретов | Снижает ценность скомпрометированных данных | Средняя |
Логирование доступа к данным | Ускоряет расследование | Низкая |
Отлаженный план реагирования | Сокращает время и ущерб | Высокая |
Человеческий фактор: самая старая и самая живучая уязвимость
Сколько бы мы ни строили технических барьеров, человек остаётся и самым сильным, и самым слабым звеном. Я видел, как технически безупречные системы падали из-за одного письма и одного клика. Поэтому работа с людьми — это не «обязательный тренинг раз в год», а постоянный процесс.
Что работает по моему опыту: регулярные короткие симуляции фишинга, но не с наказанием за клик, а с разбором и обучением; понятные и простые регламенты на подозрительные запросы; культура, в которой сообщить о своей ошибке безопасно. Если сотрудник боится признаться, что кликнул, инцидент будет обнаружен позже и дороже обойдётся.
Отдельно — доступы. Люди уходят, роли меняются, а доступы остаются. Регулярная ревизия доступов и немедленное отключение при уходе сотрудника — это то, что стоит делать автоматически, а не по памяти.
Организационные и правовые риски
Технические риски очевидны, но не менее опасны организационные. В конце 2026 года цифровой бизнес работает в среде, где требования к защите данных и устойчивости инфраструктуры ужесточаются, а цена ошибки растёт. Это касается и регуляторных требований, и договорных обязательств с партнёрами, где SLA и ответственность за простой прописаны всё строже.
Мой совет здесь простой: не относитесь к требованиям как к формальности. Компании, которые встраивают соответствие требованиям в процессы разработки, а не готовят документы к проверке в последний момент, тратят меньше и спят спокойнее. Это вопрос архитектуры процессов, а не бумаг.
Область | Типичная проблема | Что помогает |
|---|---|---|
Регуляторные требования к данным | Разрозненные процессы, ручной сбор доказательств | Автоматизация аудита и логирования |
Договоры с партнёрами | Слишком мягкие или нереалистичные SLA | Честная оценка своих возможностей и резервов |
Внутренние регламенты | Устаревшие и непроверяемые | Регулярный пересмотр и учения |
Страхование рисков | Непокрытые сценарии | Аудит покрытия и явное согласование с юристами |
Как я выстраиваю приоритеты: практическая рамка
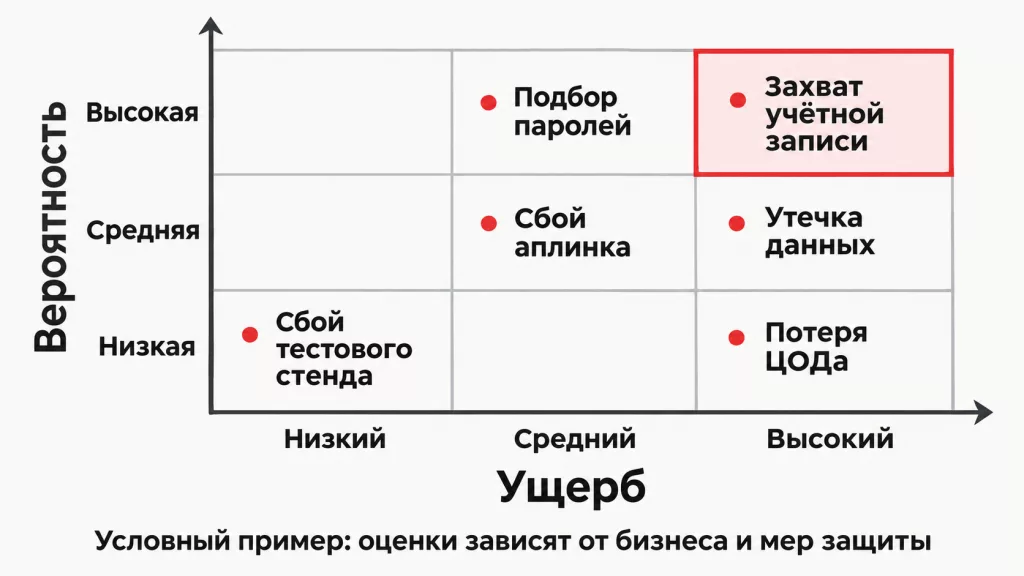
Когда рисков много, легко утонуть. За годы я выработал простую рамку, которой пользуюсь сам. Сначала — оценка критичности по двум осям: вероятность и потенциальный ущерб. Потом — быстрые победы, которые снижают риск при малых затратах. И только потом — дорогие проекты, вроде географического резервирования. Если начать с дорогого, можно потратить бюджет и всё равно остаться с базовыми дырами вроде открытых портов и слабых паролей.
Инвентаризация: что у нас есть, где оно живёт, кто имеет доступ
Оценка критичности по вероятности и ущербу
Быстрые победы: доступы, патчи, бэкапы, логирование
Устранение единичных точек отказа там, где это дёшево
Проверка процедур восстановления и переключения на учениях
Дорогие проекты: географическое резервирование, отдельные площадки
Постоянный мониторинг и пересмотр приоритетов
Бэкапы и восстановление: самое недооценённое
Я не раз сталкивался с ситуацией, когда бэкапы есть, а восстановиться из них нельзя. Причины разные: бэкапы лежат на том же сервере, что и данные; ключи шифрования утеряны; процедура восстановления не описана; никто и никогда не проверял восстановление. Бэкап без проверенной процедуры восстановления — это не защита, а самоуспокоение.
Что делаю я: разделяю резервные копии по площадкам, отдельно храню ключи, регулярно — не реже раза в квартал — провожу учения по восстановлению из бэкапа на чистой инфраструктуре и измеряю время до рабочего состояния. Это даёт не только уверенность, но и цифры, которые можно показать руководству и партнёрам.
Аспект бэкапов | Плохая практика | Хорошая практика |
|---|---|---|
Расположение | Тот же ЦОД, что и данные | Отдельная площадка или независимое хранилище |
Проверка | Никогда не проверялись | Регулярные учения по восстановлению |
Ключи | Рядом с данными | Отдельное защищённое хранение |
Документация | Отсутствует | Описана и отработана на практике |
Метрики | Нет | Время восстановления и полнота данных |
Мониторинг и обнаружение: время — главный ресурс
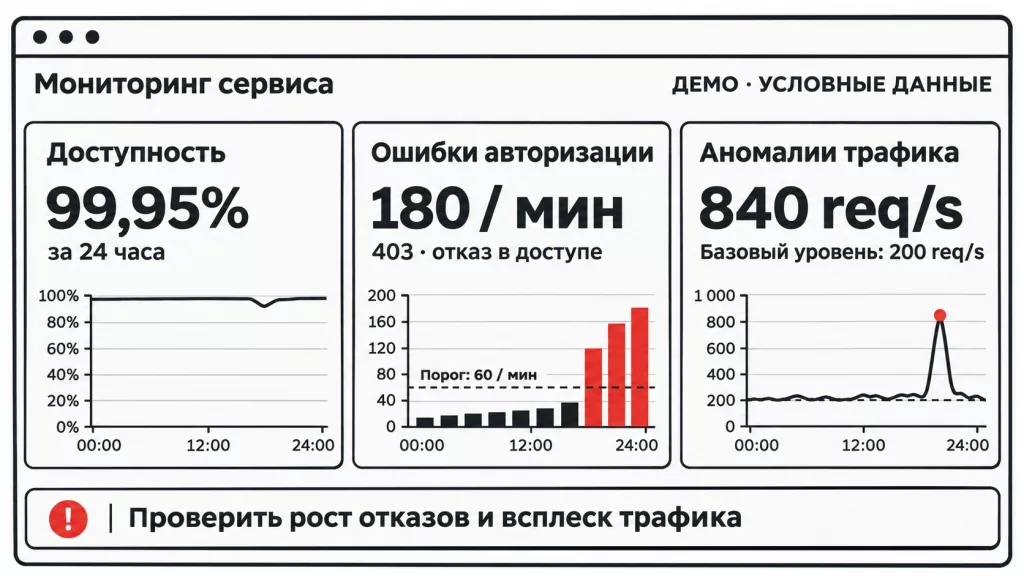
В инциденте выигрывает тот, кто узнает о нём раньше. Мониторинг в 2026 году — это не только доступность и нагрузка, но и безопасность: аномалии в трафике, подозрительные входы, изменения конфигураций, всплески ошибок авторизации. Причём важно не просто собирать события, а иметь короткий путь от сигнала до человека, который может действовать.
Практика, которую я считаю обязательной: централизованный сбор логов с приложений и инфраструктуры, алерты, которые не тонут в шуме, и дежурство с понятным регламентом эскалации. Алерт, который никто не смотрит, — это не мониторинг, а коллекция красивых графиков.
Единый сбор логов приложений, сети и инфраструктуры
Алерты на аномалии авторизации и доступа
Мониторинг изменений конфигураций и прав
Понятный регламент эскалации и дежурства
Регулярная проверка, что алерты действительно доходят до людей
Люди, процессы и культура устойчивости
Технологии — это половина дела. Вторая половина — люди и процессы. Я убеждён, что устойчивость бизнеса к инцидентам определяется не количеством инструментов, а культурой: готовностью открыто обсуждать проблемы, документировать, учиться на ошибках и не искать виноватых в момент пожара. В компаниях, где инциденты разбирают без обвинений, их обнаруживают раньше и закрывают дешевле.
Практические вещи, которые я внедряю везде, где могу: регулярные учения по реагированию на инциденты, документация процессов с актуальными контактами, ротация дежурств, разбор каждого инцидента с конкретными задачами и сроками. Это скучно, но это работает лучше любых модных инструментов.
Облако, гибрид и своё железо: где что держать
Вопрос размещения нагрузки в 2026 году — это вопрос управления рисками, а не идеологии. Своё железо даёт контроль, но требует компетенций и капитальных затрат. Облако даёт гибкость и часть защитных механизмов, но создаёт зависимость от провайдера. Гибрид даёт баланс, но требует зрелости в эксплуатации.
Мой подход: критичные данные и сервисы, которые должны жить при потере внешней площадки, держать там, где вы контролируете восстановление. Эластичную и не критичную нагрузку — туда, где удобнее и дешевле. И в любом случае проверять, как провайдер ведёт себя при инциденте: поддерживает ли он вас, когда что-то сломалось, или присылает формальный ответ через два дня.
Критерий | Своя инфраструктура | Облако | Гибрид |
|---|---|---|---|
Контроль | Высокий | Средний | Средний-высокий |
Скорость развёртывания | Низкая | Высокая | Средняя |
Зависимость от провайдера | Низкая | Высокая | Средняя |
Требования к экспертизе | Высокие | Средние | Высокие |
Стоимость при стабильной нагрузке | Ниже | Выше | Смешанная |
Экономика устойчивости: сколько это стоит и как считать
Руководство редко впечатляют слова «надо защищаться». Поэтому я всегда перевожу риск в деньги. Сколько стоит час простоя для бизнеса с учётом недополученной выручки, штрафов по договорам и затрат на восстановление? Сколько потеряем при утечке данных с учётом регуляторных последствий и оттока клиентов? Когда эти цифры посчитаны, разговор о бюджете на резервирование и защиту идёт совершенно иначе.
И отдельно — про стоимость инцидента в сравнении со стоимостью мер. Почти всегда быстрые меры — доступы, патчи, проверенные бэкапы, минимальное резервирование — стоят на порядок меньше, чем инцидент, который они предотвращают или смягчают. Это лучший аргумент в разговоре с бизнесом, который я знаю.
Тип меры | Порядок затрат | Ожидаемый эффект |
|---|---|---|
Гигиена: доступы, патчи, секреты | Низкий | Снижение вероятности самых частых инцидентов |
Проверенные бэкапы и учения | Низкий-средний | Сокращение времени восстановления |
Мониторинг и алерты | Низкий-средний | Раннее обнаружение |
Разнесение по площадкам | Высокий | Выживание при потере площадки |
Собственный резервный ЦОД | Очень высокий | Максимальная автономность |
Чек-лист, с которым я захожу в любой проект
В завершение — рабочий чек-лист, который я адаптирую под каждый проект. Он не заменяет глубокого анализа, но помогает быстро найти самые очевидные пробелы и закрыть их. Большинство крупных проблем, которые я видел, ловились именно на этих базовых пунктах.
Инвентаризация инфраструктуры и данных актуальна и доступна
Доступы выдаются по принципу необходимости и регулярно пересматриваются
Секреты хранятся в защищённом хранилище и не попадают в код и логи
Бэкапы лежат отдельно и проверяются на восстановление по регламенту
Есть минимум два независимых канала связи и разнесение критичных площадок
В пайплайне есть проверки зависимостей и сканирование секретов
Мониторинг безопасности покрывает авторизацию, доступ и конфигурации
Есть план реагирования с контактами и ответственными
Проводятся учения по реагированию и переключению
Сотрудники знают, куда сообщать о подозрительных запросах
Контракты с партнёрами отражают реальные SLA и ответственность
Оценён экономический ущерб от простоя и утечки для приоритизации мер
Вывод: устойчивость — это процесс, а не проект
Если свести всё к одной мысли, она будет такой: в конце 2026 года ни один цифровой бизнес не может позволить себе относиться к рискам как к разовой задаче. Ландшафт угроз меняется непрерывно, и вместе с ним должна меняться ваша защита. Побеждают не те, у кого самый большой бюджет на безопасность, а те, кто выстроил процессы, культуру и архитектуру, способные выдержать удар и быстро восстановиться.
Начните с базового: доступы, патчи, проверенные бэкапы, мониторинг и люди, которые знают, что делать. Потом переходите к разнесению площадок и работе с цепочками поставок. И не забывайте проверять всё на учениях — потому что защита, которую никогда не проверяли, — это вера, а не инженерия.